Recursos

Fraude

Fraude en solicitudes de crédito y pagos: controles, investigación, huella digital y operación antifraude

Cálculo de distancia con la ley de cosenos esférica para detectar fraude en el comercio electrónico

Este artículo explica cómo calcular distancias de círculo máximo a partir de latitud y longitud con la ley de cosenos esférica, y cómo aplicar esa lógica en un motor de decisiones para verificar clientes, definir geocercas y detectar fraude en el comercio electrónico. Compara la fórmula con Haversine, presenta la ecuación y los pasos de implementación, y explica las diferencias de precisión según la distancia.
Lectura: 5 min

Detección de round tripping en el análisis de transacciones para préstamos a pymes

Los equipos de préstamos a pymes ahora pueden analizar datos de transacciones sin ser un banco. Open Banking permite acceder directamente a las transacciones, y eso cambia la evaluación crediticia.También crea un problema de fraude: el round tripping. Los solicitantes pueden mover dinero de entrada y salida para inflar los ingresos, y las comprobaciones simples de extractos bancarios pasan por alto ese patrón.

Lectura: 9 min

Evercookie: Un mecanismo de seguimiento persistente

Evercookie es una técnica de JavaScript que escribe el mismo identificador en múltiples ubicaciones de almacenamiento del navegador para resistir su eliminación. Si se borra un almacenamiento, se reconstruye a partir de los demás, lo que permite un seguimiento persistente entre sesiones. Este artículo explica cómo funciona, sus límites técnicos y legales, y los pasos prácticos que los usuarios pueden tomar para reducir la exposición.

Lectura: 1 min

Fingerprinting de WebGL: rastreo de usuarios en línea mediante el renderizado gráfico

El fingerprinting de WebGL usa la API WebGL del navegador para renderizar gráficos y revelar rasgos de renderizado propios del dispositivo. Este artículo explica cómo funciona la técnica y cómo encaja en un contexto más amplio de device fingerprinting. También cubre sus límites y los métodos de suplantación más comunes.

Lectura: 3 min

Construir competencia antifraude sin perder el control de tus datos

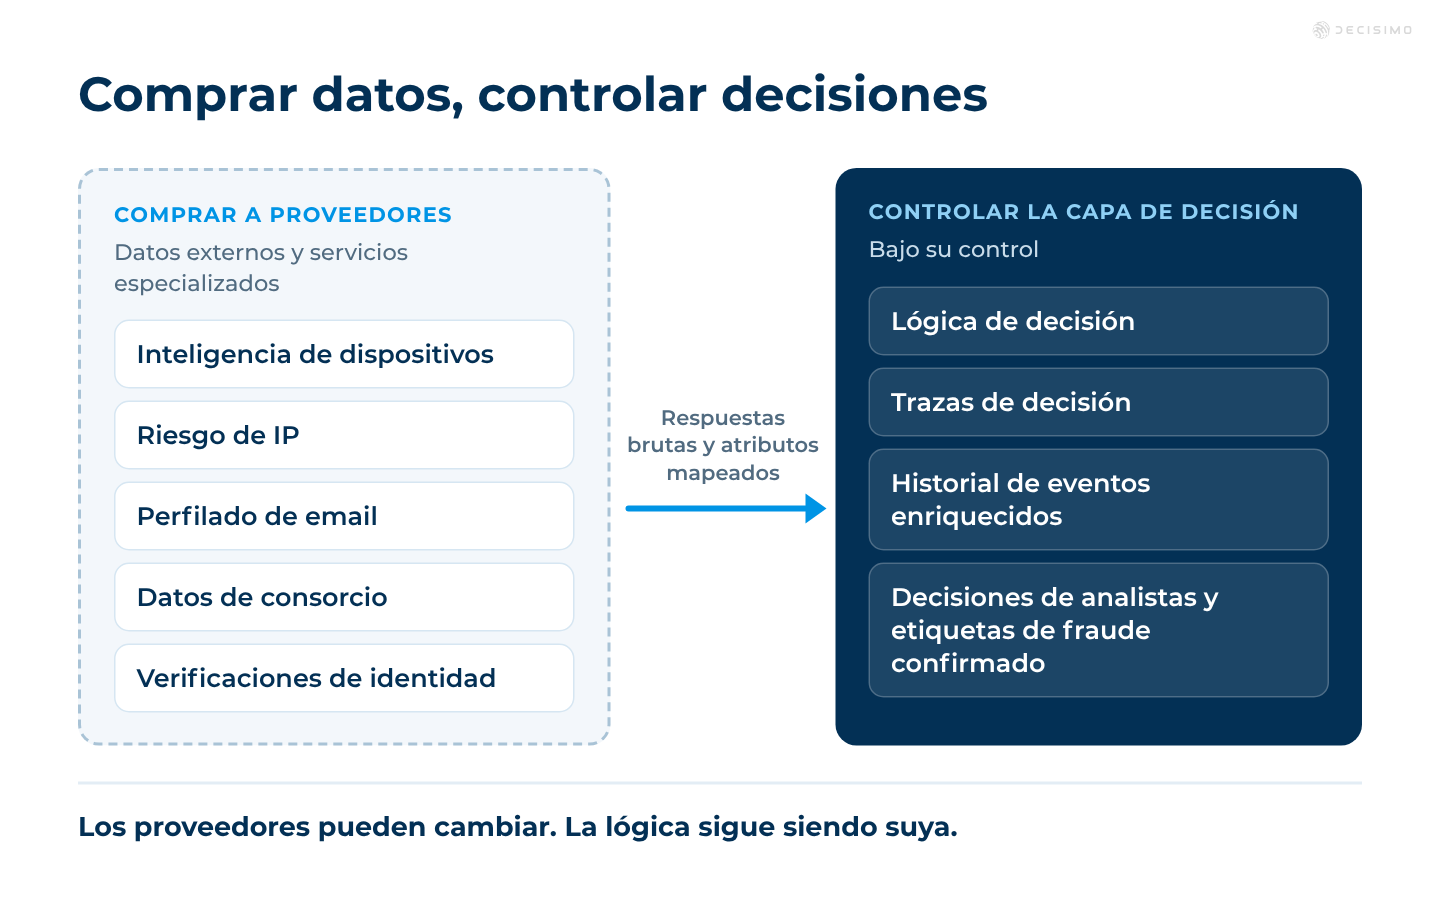
El antifraude no es un producto que se instala una vez y se olvida. Es una capacidad operativa construida a partir de datos, lógica de decisión, trazabilidad y ajuste continuo a lo largo del recorrido del cliente. Las empresas pueden comprar partes de ese stack, pero si externalizan la lógica central y los datos enriquecidos, a menudo crean un problema de dependencia del que luego es difícil salir.

Lectura: 10 min

La verdadera naturaleza del fraude y cómo construir un antifraude que funcione

La mayoría de los programas antifraude se centran en solicitudes individuales maliciosas, identidades robadas o transacciones sospechosas. Eso importa, pero pasa por alto el punto principal. El verdadero problema del fraude no son oportunistas aislados. Son actores organizados que tratan el fraude como un negocio, calculan el retorno de la inversión y atacan primero a los operadores más débiles.

Lectura: 9 min

Cómo usar un Rule Engine para adaptar tu estrategia antifraude

Un rule engine te da control sobre la lógica antifraude. En lugar de depender de comprobaciones genéricas, puedes combinar datos de terceros, listas de bloqueo de IP, y tus propias señales de transacción para definir reglas que encajen con tu perfil de riesgo. Este artículo muestra cómo adaptar las reglas antifraude para ecommerce, incluyendo comprobaciones de direcciones IP, análisis de velocity, y condiciones personalizadas que ayudan a señalar actividad sospechosa antes de que se convierta en una pérdida.

Lectura: 5 min

El conflicto entre las técnicas de minimización de datos y el auge de los perfiles sintéticos fraudulentos

Los controles de privacidad reducen los datos que las empresas pueden recopilar, pero también dificultan la detección del fraude con perfiles sintéticos. Este artículo explica dónde aparece esa compensación en los pagos online, cómo los estafadores usan técnicas de minimización de datos para ocultar actividad y por qué se necesita una lógica de detección más sólida cuando hay menos señales disponibles.

Lectura: 3 min

Investigación antifraude en lending: cómo detectar, rastrear y validar el riesgo

El fraude en lending rara vez empieza con una sola señal clara. Suele aparecer como un patrón: un cambio de concentración, un grupo de entidades relacionadas, o un cambio brusco de comportamiento en solicitudes y transacciones. Un proceso sólido de anti-fraud ayuda a los equipos a dimensionar el caso desde el inicio, validar lo que muestran los datos y decidir qué hacer después.

Lectura: 8 min

Private State Tokens en la antifraude online: qué cambian y dónde encajan

Private State Tokens son una señal que preserva la privacidad para la confianza online. Pueden ayudar a separar usuarios reales de abuso automatizado sin depender del fingerprinting tradicional, que cada vez es más difícil de usar a medida que los navegadores endurecen los controles de privacidad.

Lectura: 8 min

Herramientas utilizadas en la prevención del fraude en línea

La prevención del fraude en línea utiliza comprobaciones de pasarela, enriquecimiento de datos, modelos de ML, controles de contracargos, monitorización de transacciones y gestión de casos para reducir el fraude en e-commerce. Este artículo describe estos métodos y muestra cómo codificarlos en una lógica de decisión auditable para una detección de fraude repetible.

Lectura: 2 min